ブランドLLMO
 逆SEO対策
 サジェスト対策
 採用ブランディングサービス

SEOやAI対策において「一次情報が大事」と耳にする機会が増えました。
しかし「AIは本当に一次情報を好むのか?」「本当にそこまで引用に差が出るのか?」と、疑問を感じている方も多いのではないでしょうか。
実際、AI検索(ChatGPTやGemini等)やGoogle検索において、現場の実体験や独自データといった一次情報は、回答の根拠や検索上位として選ばれる重要な要素となりつつあります。
本記事では、なぜAIや検索エンジンが一次情報をこれほど重視するのかという仕組み(RAGやE-E-A-Tなど)から、AIに正しく引用されるためのテクニック、さらにはリソースが限られた中で一次情報を生み出すアイデアまでを解説します。
単なる一般論にとどまらず、弊社アクシアカンパニーが実際に公開している独自調査などのリアルな実例を交えながら具体的に紐解いていきます。
AI引用の獲得と持続的なSEO評価を両立させたい方は、ぜひ参考にしてください。
そもそも「一次情報」とは?
一次情報とは、自らの実体験や独自調査、実験などによって直接生み出された「加工されていないオリジナルの情報」のことです。
AIで汎用的な情報を瞬時に生成できる現代だからこそ、この一次情報の価値がかつてないほど高まっています。
まずは一次情報の正確な定義と二次情報との違い、そしてWebコンテンツにおける具体的な該当例を解説します。
- 一次情報の定義、二次情報との違い
- Webコンテンツの代表的な一次情報
一次情報の定義、二次情報との違い
一次情報とは発信者が自らの体験や調査によって直接生み出したオリジナルの情報であり、二次情報とは既存の情報を要約・整理・再構成した情報を指します。
両者には「情報の発生源」と「独自性」において明確な境界線が存在します。
| 一次情報 | 発信者が自らの手足や思考を動かして直接獲得したオリジナルの事実であり、 他者のフィルターを通していないデータや直接的な見解のこと。 第三者が容易に模倣できない高い希少性と証拠能力を持ちます。 |
| 二次情報 | 既に世の中に公開されている一次情報を集め、 整理・要約・分析などの加工を加えた情報のこと。 読者の理解を早める利便性を持つ一方で、情報源の信憑性に依存し、 他者による代替が容易です。 |
ここで着目すべきは、生成AIによって出力されるコンテンツも本質的には二次情報に過ぎないという点です。
生成AIは膨大な既存データを学習し、可能性の高い単語の並びを予測して文章を組み立てているため、AI自身が新たな事実を発見したり直接体験したりすることはできません。
既存情報の焼き直しが溢れ返る現代だからこそ、情報源の起点となる一次情報の方が信頼性の高いコンテンツと言えます。
Webコンテンツの代表的な一次情報
Webコンテンツにおける代表的な一次情報とは、他サイトの情報をまとめ直したものではなく、発信者が自らの五感や手を動かして直接得たオリジナルの体験やデータです。
Web上では主に以下のような形式で発信されています。
自費で購入した製品の使用感や、自ら撮影した写真・動画、長期間使って初めて判明したデメリットなどの具体的な検証記録。
店舗や観光地、イベントなどに実際に訪れた人にしかわからない状況、現地のリアルな空気感、自身の体験談。
不特定多数の人を集めて取ったアンケート調査や、複数のやり方を実際に試して比較した測定数値などのオリジナルデータ。
これらはすべて、既存のネット情報を調べるだけでは絶対に作れない「発信者自身が行動したからこそ得られた事実」です。
カタログスペックや他人の口コミのまとめにはない生々しい実体験こそが、読者に安心感と強い納得感を与えます。
なぜAI時代に「一次情報」がこれほど重要視されるのか
AI時代に一次情報が重視されるのは、AIによって誰でも似たようなコンテンツを瞬時に大量生成できるようになり、一般論や既存情報の価値が相対的に暴落したためです。
既存情報を再構成しただけのコンテンツがWeb上に溢れる中、自ら体験・検証して獲得した「事実」だけは他者には真似できない唯一無二の差別化要素となります。
また、生成AIツールやGoogleのAI検索でも、独自性のある情報が重視される傾向にあります。
AI生成物は既存データをもとにしており、独自の一次情報を持たないから
一次情報がこれほど重要視される大きな理由は、生成AIは学習データをもとに新たな文章を生成するため、自らの実体験や独自調査に基づく一次情報を持つわけではないためです。
AIの情報収集アプローチは、大きく2つに分かれます。
1つは過去に読み込んだ膨大な記憶をもとに回答する学習データ、もう1つは最新のWeb検索結果を参照して回答を組み立てるRAG(検索拡張生成)です。
手法こそ異なりますが、どちらも「誰かが既に発信した既存のデータ」をもとに文章を生成している点に違いはありません。
当たり前ですが、AI自身が実際に製品を触ったり、現場で汗を流して検証したりして、新しい事実を生み出しているわけではないのです。
そのため、AIが生成する内容はどれほど論理的で流暢であっても、既存情報の最大公約数的なまとめの枠から抜け出せません。
AIの既存の学習データにもWeb検索の参照先にもまだ存在しない、自ら手を動かして獲得したオリジナルの一次情報に圧倒的な価値が宿ります。
AI検索(ChatGPTやGemini等)で回答の根拠として活用される可能性があるから
AI時代に一次情報が重要視されるもう1つの理由は、ChatGPTやGeminiなどのAI検索において、検証可能な具体的情報は回答の根拠として活用される可能性があるからです。
AI検索では誤情報(ハルシネーション)を抑えるため、外部の情報源を参照して回答を組み立てる仕組みが取り入れられています。
具体的な数値や引用がAI回答に与える影響については、研究データも報告されています。
米プリンストン大学などの研究チームが発表したGEO(生成エンジン最適化)に関する論文「GEO: Generative Engine Optimization」によると、統計データや引用文の追加といった手法により、AI回答内での露出が最大約40%向上したことが報告されています。
他サイトの情報をなぞっただけのコンテンツは埋もれやすい一方で、数値に裏付けられた独自調査や検証ログを持つコンテンツは、回答の根拠として引用される可能性が高まります。
AI検索からの露出や流入を獲得する上でも、一次情報の有無は大きな差となっていきます。
参考:GEO: Generative Engine Optimization
Google検索のAIガイダンスでも独自性が明記されているから
AI時代に一次情報が不可欠とされる背景には、検索最大手であるGoogleがAI検索機能において、独自の視点や体験の重要性を明確に打ち出している点も挙げられます。
Googleが公開した「Google 検索における生成 AI 機能に向けた最適化のための Google ガイド」では、AI検索(AI OverviewsやAIモード)でウェブサイトの露出を高める要素として「独自の価値ある優れたコンテンツ」が重要であることが明記されています。
ガイド内では、既存コンテンツの要約は他の場所ですでに手に入る情報の言い換えに過ぎず、生成AIモデルで簡単に作成できる内容を単に再利用しないようにと警告されています。
さらに、誰でも発信できるコモディティ化した一般論ではなく、「個人的な経験に基づいた独自の視点」や「一般的な知識や通常の範囲を超えた専門的・経験的な見解」を盛り込むことを推奨しています。
つまり、自ら手を動かして得た実体験や独自調査といった一次情報を含む独自性の高いコンテンツは、GoogleがAI検索(AI OverviewsやAIモード)に向けて推奨する方向性と一致しているのです。
参考:Google 検索における生成 AI 機能に向けた最適化のための Google ガイド
生成AIが外部情報を参照する仕組みと一次情報の関係
生成AIの回答に一次情報が参照される背景には、最新かつ信憑性の高い外部データを取得し、回答の正確性を高める仕組みがあります。
AIは過去の学習データだけに依存すると情報の陳腐化や誤情報の出力を防げないため、Web上から確かな事実をリアルタイムに補う処理を実行します。
AIが外部情報を取り込んで回答するプロセスを、以下の2つの仕組みから解説します。
- 【RAG】学習済みデータにない情報をウェブから補う
- 【グラウンディング】外部情報と紐付けて回答の信頼性を高める
【RAG】学習済みデータにない情報をウェブから補う
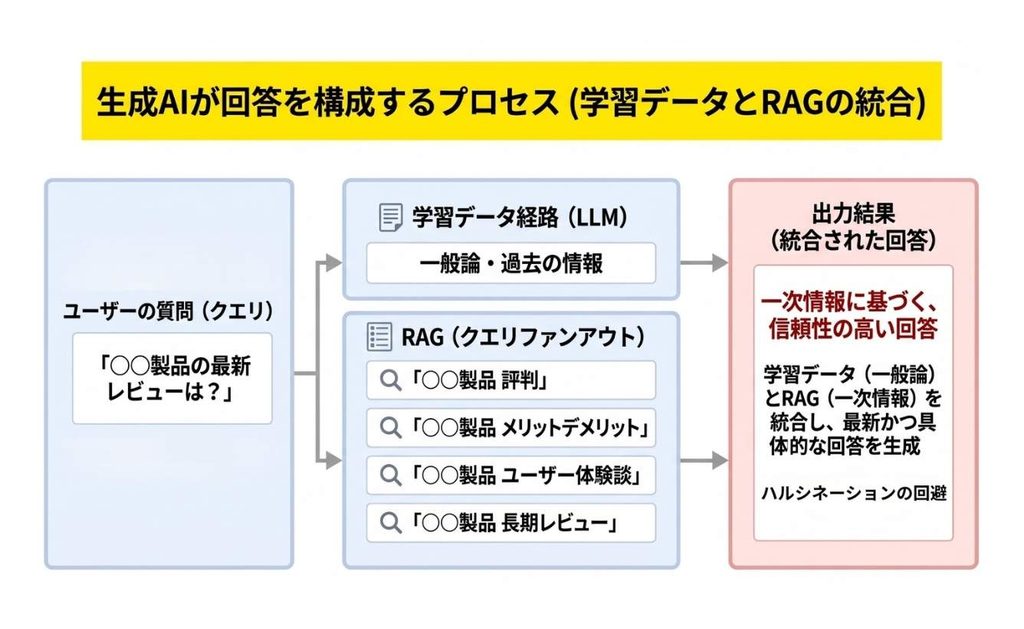
生成AIが外部情報を取り込む処理プロセスにおいて、中心的な役割を担っているのがRAG(検索拡張生成)と呼ばれる技術です。
AIのモデルが保持している学習データは過去のある時点で固定されているため、日々更新される最新情報やニッチな事実までは把握できません。
そこでRAGは、ユーザーから質問を受けた瞬間に外部のWebインデックスを検索し、関連性の高いページをリアルタイムで取得した上で、その情報をモデルに読み込ませて回答を生成します。
さらにGoogleのAIモードなどでは、この検索過程で「クエリファンアウト」と呼ばれる処理も実行されます。
これは、ユーザーの質問(プロンプト)から関連する複数の検索クエリをAIが同時生成し、より多角的かつ深掘りした情報をウェブ全体からかき集める仕組みです。
この情報取得のプロセスにおいて、価値を発揮しやすいのが一次情報です。
既に学習データに含まれているような一般論や二次情報ではなく、未学習の「最新の検証ログ」「独自のアンケート数値」「現場の実体験」といった新規のファクトをWebから補うことで、回答の質を高められるからです。
RAGという検索補完の仕組みが広がったことで、Web上にしかない生きた一次情報を持つサイトも、関連性や信頼性などに応じて回答の参照元となる可能性があります。
【グラウンディング】外部情報と紐付けて回答の信頼性を高める
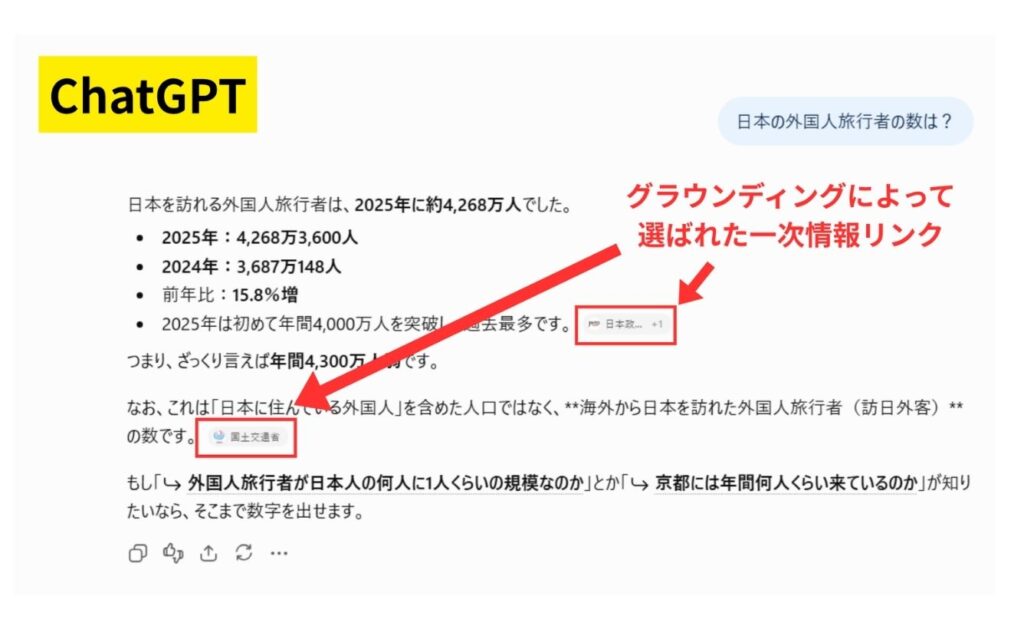
画像出典:ChatGPT
グラウンディングとは、生成AIの出力内容を「検証可能な外部の情報源」に直接紐付けることで、事実無根の嘘を出力するハルシネーションを防止する技術です。
生成AIは確率論で文章を構築するため、そのままでは事実に基づかないもっともらしい虚偽を生成してしまうリスクを常に抱えています。
そこでグラウンディングを用いることで、モデルのレスポンスを信頼できる特定のデータソースにしっかりと固定し、生成物によるねつ造を強力に抑制します。
さらに、回答の根拠となった情報源へのリンクを提示できるようになり、回答の客観的な裏付けと監査可能性を担保することが可能になります。
グラウンディングの対象は一次情報に限りませんが、「検証可能な事実」を豊富に含む一次情報は、回答の根拠として紐付けやすい情報と言えます。
独自の調査データや現場の実体験といった確かな情報に回答を紐付けることで、AIはより信頼性の高い回答をユーザーに届けられるようになります。
AIに引用される「一次情報」の具体的な種類と作り方
AIに信頼できる一次情報として引用されるためには、客観的なファクトと独自性の両立が不可欠です。
ここでは代表的な一次情報の種類と、具体的なコンテンツへの落とし込み方を解説します。
解説にあたっては、弊社アクシアカンパニーがこれまで実際に制作・発信してきた独自調査や事例などの一次情報コンテンツの具体例を交えながら、その実践的な作り方を紹介します。
独自調査データ・アンケート
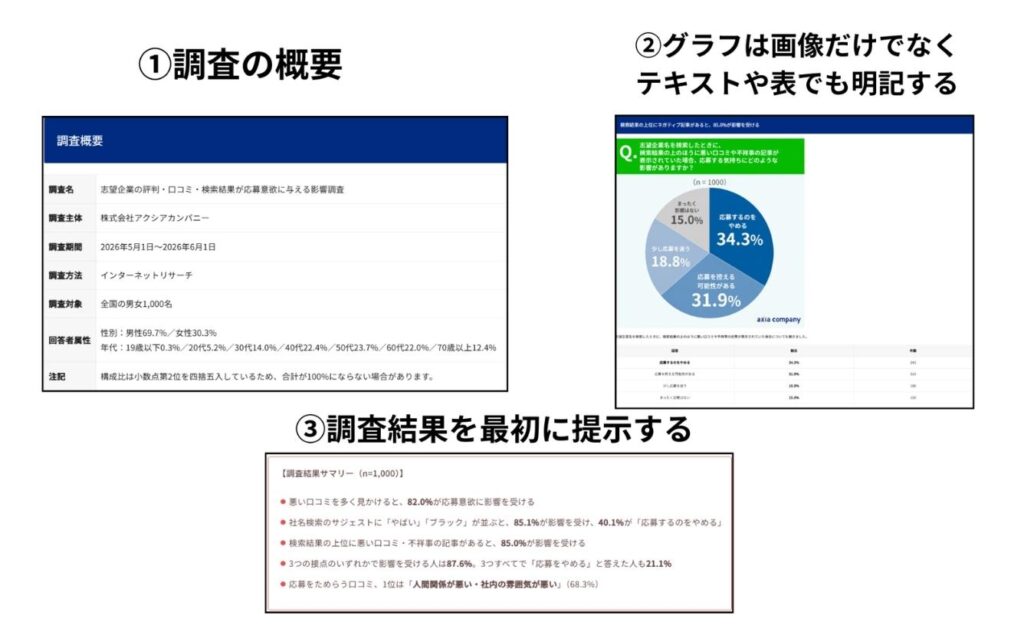
画像出典:アクシアカンパニー 【1,000人調査】志望企業の評判・口コミ・検索結果が応募意欲に与える影響調査
独自調査データやアンケートは、Web上にまだ存在しない客観的な数値ファクトとなるため、生成AIの回答の根拠として引用されやすい一次情報です。
弊社アクシアカンパニーが実施した「志望企業の評判・口コミ・検索結果が応募意欲に与える影響調査」では、AIに正しく抽出されるように、以下の3つのポイントを重視しています。
①調査の概要
調査期間や対象者、サンプル数などの実施条件を詳細に明記し、データの客観性と信頼性を担保する。
②グラフは画像だけでなくテキストや表でも明記する
AIが数値を読み取りやすいよう、グラフ画像に加えてHTMLの表やテキストでも同一数値を記述する。
③調査結果を最初に提示する
読者とAIが要点を即座に把握できるよう、最も伝えたい数値サマリーをコンテンツの上部に配置する。
これらを徹底することで、AIが自社の調査結果を正しく読み取り、回答データとして引用しやすくなります。
実機レビュー・比較検証ログ
製品やサービスのカタログスペックを並べただけのコンテンツは誰でも作成できますが、実際に自らの手で操作・計測して得た「実機レビュー・比較検証ログ」は、生成AIが代替できない一次情報となります。
これはAIが「どちらが優れているか」「実際の性能差や使用感はどうか」といったプロンプトに回答する際、実際に現場で検証されたデータが不可欠な根拠となるからです。
比較検証ログを作成する際は、単なる感想文に終わらせず、以下のポイントを押さえて客観的なコンテンツとして組み立てます。
| 検証環境と前提条件を統一して明記する | どのような環境、端末、バージョン、期間でテストを実施したのか等を詳細に提示し、検証の再現性と公平性を担保する。 |
| 公称値と実測値のギャップを記録する | 公式サイトに書かれているスペックや効果をなぞるのではなく、実際に運用・試行して判明した処理速度、コスト、想定外の挙動といった「実測データ」を提示する。 |
| デメリットや懸念点も客観的に提示する | メリットばかりを並べるのではなく、実際に検証したからこそ分かった不具合や使いづらさ、向いていないケースを率直に記載することで、情報の信憑性を決定づける。 |
| レビューや検証時の様子を写真や動画にする | 実際に手元で操作している様子や作業現場、計測画面のキャプチャなどを掲載し、机上の一般論ではない「実体験の確かな証拠」を読者とAIに視覚的に証明する。 |
自社コンテンツへ落とし込む際は、自社サービスと他社サービスを公平な条件で比較し、対応範囲や費用、効果が出るまでの期間などを客観的な比較表や実測データで提示することが有効です。
単に自社を優位に見せるのではなく、他社が適しているケースや自社のデメリットまで包み隠さず明記することで、情報の客観性が担保され、AI検索における比較クエリの信頼できる参照元として引用されやすくなります。
実績数値・導入事例
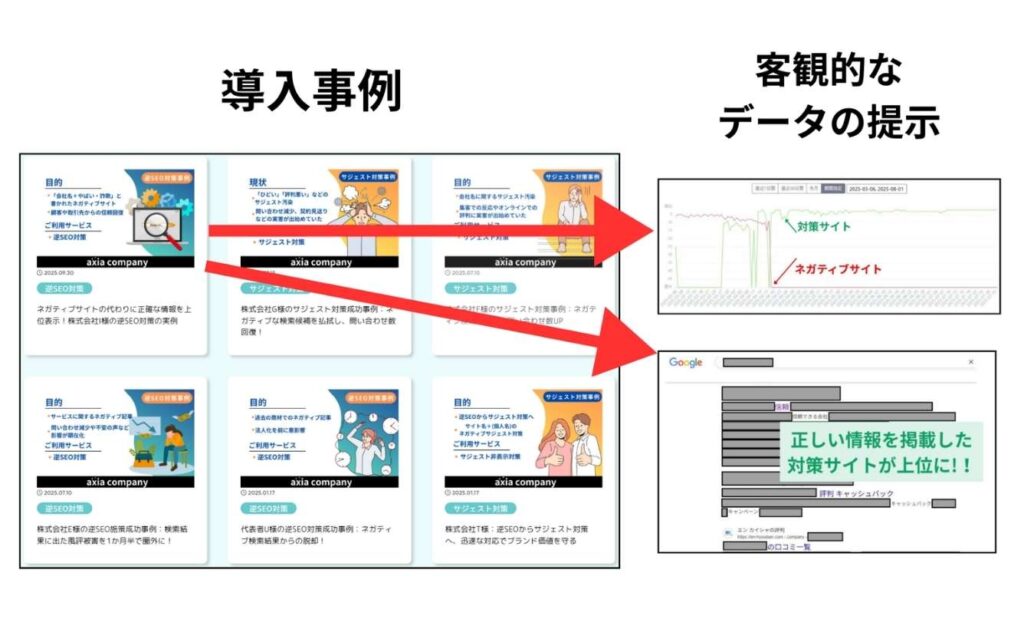
画像出典:アクシアカンパニー 事例紹介
自社が実際に顧客へ価値を提供した「実績数値・導入事例」は、他社が模倣できない強力な一次情報です。
製品やサービスの特長やスペックを語るだけでなく、「実際にどのような課題に対し、どうアプローチして、どんな結果が出たのか」という現場のプロセスと数字を示すことで、コンテンツの説得力は向上します。
ただし、単に「成果が出ました」「顧客満足度が向上しました」といった定型文のような感想を並べるだけでは、AIにも読者にも客観的なファクトとして認識されません。
事例を一次情報として機能させるためには、客観的なエビデンスをセットで提示することが重要です。
弊社アクシアカンパニーの逆SEO対策の事例紹介ページでは、対策サイトとネガティブサイトの順位推移を記録した計測グラフや、実際に上位表示された検索結果の画面キャプチャなど、第三者から見ても結果が一目で検証できるデータを明記しています。
このように「対策期間」「具体的な変動数値」「実際の画面ログ」といった検証可能な客観データを事例内に組み込むことで、プロモーションではない信頼に足る一次情報へと昇華します。
AIが具体的な効果や実績を収集する際にも、こうした数値エビデンスに裏付けられたコンテンツは、精度の高い根拠として引用されやすくなります。
社内専門家の見解・考察を交えたインタビュー
実務経験に裏付けられた社内専門家の独自の「見解・考察」は、他社との差別化を図れる貴重な一次情報です。
生成AIはWeb上の既存情報を要約・整理することは得意ですが、実際の現場で試行錯誤を重ねた専門家ならではの判断基準や、実務に基づいた深い洞察・見解を自発的に生み出すことはできません。
自社のエンジニア、コンサルタント、現場責任者などが持つ「この課題には実務上どう対処すべきか」「業界の最新動向を現場目線でどう捉えているか」といった生の声は、机上の一般論とは一線を画す説得力を生み出します。
専門家の役職や実名、これまでの実績を明記したうえで、現場の第一線で培われた知見や考察をインタビュー形式で落とし込むことで、コンテンツの専門性と信頼性は格段に高まります。
「誰がどのような根拠を持って語っているのか」という発信元の属性と文脈が明確な独自見解は、AI検索にとっても信憑性の高い固有のファクトとして認識され、信頼できる引用元として選ばれやすくなります。
失敗事例やトラブル解決の体験談
成功事例や一般的なノウハウはWeb上に溢れていますが、現場で実際に起きた「失敗事例やトラブル解決の体験談」は、痛みを体験した当事者しか発信できない希少な一次情報です。
多くの企業は失敗を伏せがちですが、読者が本当に求めているのは「どんなリスクがあり、失敗時にどうリカバリーしたのか」という生々しい教訓です。
試行錯誤の末に直面したトラブルや想定外の失敗、そこから立て直した具体的なプロセスは、机上の一般論を学習しただけのAIには再現できません。
コンテンツへ落とし込む際は、「直面した課題」「失敗の原因」「具体的な解決手順」「そこから得た教訓」の4要素を、客観的なファクトとして包み隠さず提示します。
リアルな葛藤と解決策が記録されたトラブルログは、読者からの深い信頼を獲得するだけでなく、AIがユーザーへのトラブルシューティングを提示する際にも信頼できる根拠として引用されやすくなります。
Webコンテンツで「一次情報」を扱う際の注意点
一次情報はAI検索への引用やユーザーからの信頼獲得において強力な武器となりますが、ただ闇雲に盛り込めば成果が出るわけではありません。
独自の調査や検証ログをまとめるには相応の工数とコストがかかるため、運用の優先度を見誤ると制作リソースが圧迫されるだけでなく、読者が求める検索意図と乖離してしまうリスクもあります。
また、自社で苦労して取得した貴重なデータが他サイトに無断で消費されてしまわないよう、適切な自衛策を講じておくことも欠かせません。
- すべてのコンテンツに盛り込まずニーズに応じて使い分ける
- 無断転載へのクレジット対策を行う
すべてのコンテンツに盛り込まずニーズに応じて使い分ける
一次情報はAI検索やユーザーからの信頼獲得に有効ですが、制作しているすべてのWebコンテンツに無理に盛り込む必要はありません。
検索ユーザーのニーズに応じて、適切に使い分けることが重要です。
- 「〇〇とは」など、ユーザーが用語の客観的な定義や概念の要約だけを端的に確認したい場合
- 法律、公的制度、行政手続きなど、独自の見解や主観を挟まず公的機関の公式情報・正確性が最優先される場合
- 製品の基本スペック、発売日、料金表など、公式サイトに記載された確定情報の確認のみが目的の場合
- エラーコードの対処法や機器の初期設定など、公式マニュアル通りの最短手順を直ちに知りたい場合
何でも一次情報を盛り込もうとするのではなく、ユーザーの検索意図を見極め、必要な箇所に絞って独自のファクトを投下することが効率的なコンテンツ運用に求められます。
無断転載へのクレジット対策を行う
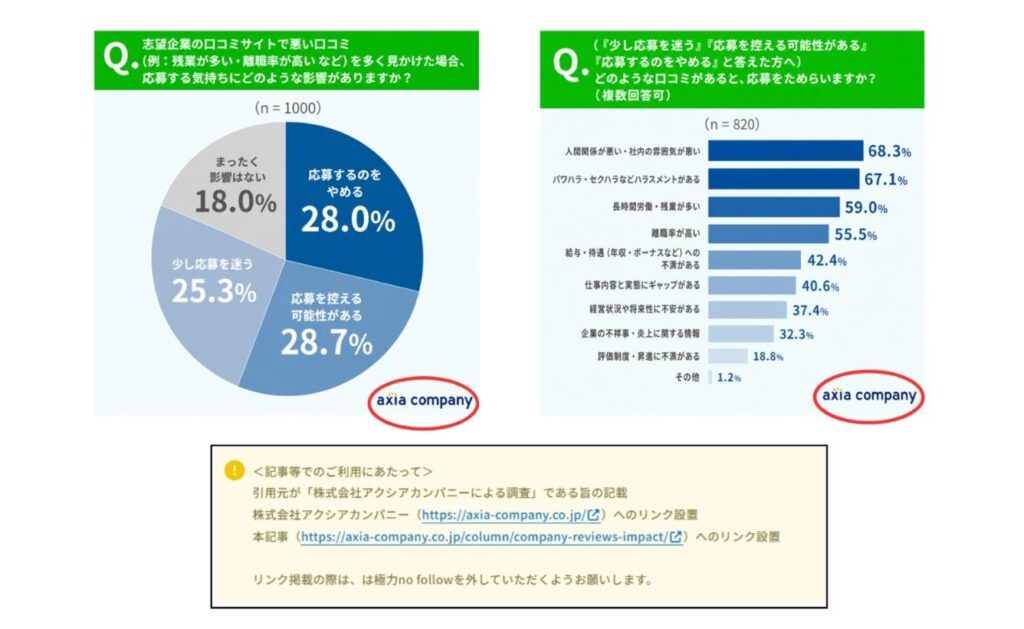
画像出典:アクシアカンパニー サジェスト・検索結果で約8割が印象悪化。ネット上の評判が信頼を左右する実態
独自調査データのような一次情報は、他サイトから引用・転載されやすい反面、クレジットなしでデータだけを都合よく消費されてしまうリスクを常に抱えています。
自社が時間とコストをかけて作成した貴重な資産をただのフリー素材にしないためには、公開時にあらかじめ適切なクレジット対策を講じておく必要があります。
弊社アクシアカンパニーの調査レポートでも、無断転載を抑止しつつ正当な被リンク・サイテーションを獲得するために、以下の2つの対策を徹底しています。
グラフや検証画像の中に自社ロゴ・社名を配置する
画像単体がコピーされて他サイトやSNSに掲載されたり、画像検索に表示されたりした場合でも、ひと目で自社が作成元であると識別できるよう、グラフ内に企業ロゴをあらかじめ組み込んでおきます。
コンテンツ内に具体的な引用・転載ルールを明記する
データを外部で利用する際の条件として、「調査主体の明記」と「自社トップページおよび調査記事へのリンク設置」を明記します。
一次情報を発信する際は、守り(無断盗用の防止)と攻め(被リンク・言及の獲得)の両面を意識したクレジット対策が、コンテンツの価値を自社サイトの評価へと確実に還元させるために必要です。
制作した一次情報をより正しく認識・引用させるテクニック
独自調査や検証ログといった質の高い一次情報を用意しても、生成AIやAIが情報収集に使う検索エンジンに正しく読み取られなければ、回答の参照元として引用されることはありません。
AIは人間のように文脈を感覚的に汲み取るのではなく、テキストデータやHTMLの構造、データの客観性、ドメインの信頼性を機械的に判定して情報を収集・統合します。
ここでは、制作した一次情報をAIに正しく認識・引用させるためのより実践的なテクニックを解説します。
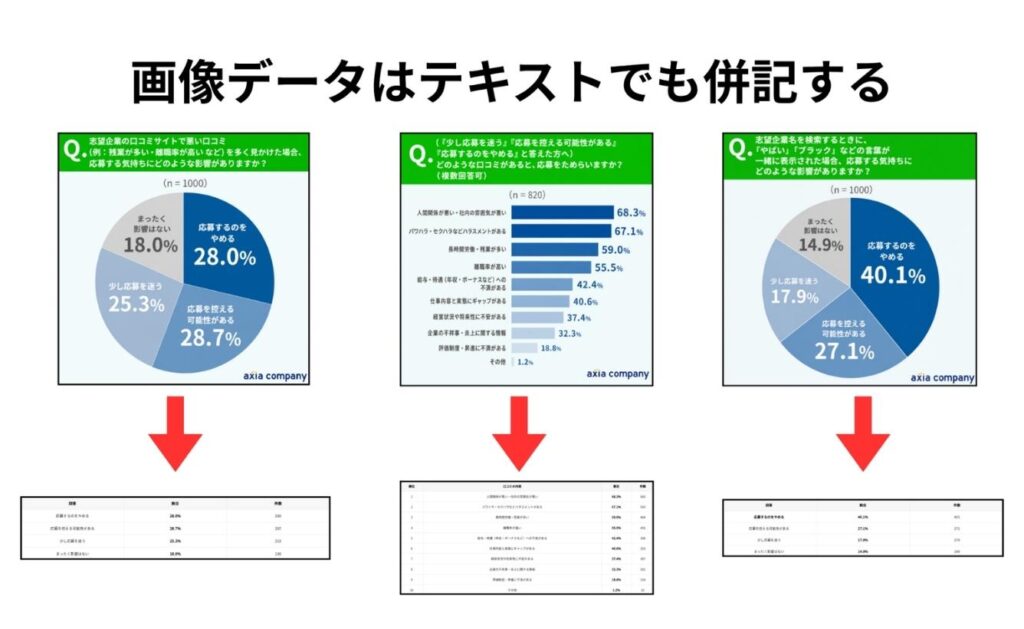
グラフは画像だけにせずテキストや表でも併記する
画像出典:アクシアカンパニー 【1,000人調査】志望企業の評判・口コミ・検索結果が応募意欲に与える影響調査
マルチモーダルAIの進化により画像読み取り(OCR)の精度は上がっているものの、画像内に埋め込まれた細かな数値やグラフの軸、割合のニュアンスを100%誤認なく解釈できるとは限りません。
HTML上のテキストデータや表(tableタグ)として記述されている情報は、クローラーや言語モデルにとって読み取りやすくなる可能性があります。
グラフを画像データだけで完結させてしまうと、貴重な調査数値がテキストとして読み取られず、引用元の候補から漏れてしまうおそれがあります。
そのため、グラフ画像を掲載する際は、必ずその直下や周辺にHTMLの表形式や箇条書きテキストなどで併記することが重要です。
人間のユーザーに向けた視覚的な伝わりやすさは画像で担保しつつ、AIに対してはテキストや表で機械的な可読性を担保する。
この二重の設計を行うことで、AIが数値を読み取りやすくなり、回答データとして正しく引用される可能性が高まります。
調査概要(N数・実施期間)や検証条件などは詳細に記述する
生成AIが回答の根拠として一次情報を引用する際、「○○%が回答した」という数値だけでなく、「その数値がどのような前提条件のもとで計測されたのか」という客観的なエビデンスも重視します。
前提が曖昧なデータはハルシネーションのリスクを孕むため、AIから信頼性の低い情報と判定されかねません。
調査データや検証ログを公開する際は、以下の基本項目をコンテンツ内に明記します。
- 調査・検証の主体(実施企業名・調査機関)
- 調査対象および属性(対象者の地域、年齢層、性別、職業など)
- サンプルサイズ(有効回答数・N数)
- 調査期間および検証日時(データの鮮度・最新性を担保)
- 調査方法や検証環境(インターネットリサーチ、使用ツールなど)
実施条件が細かく記述されているほど、AIに検証可能性の高いファクトとして認識されやすくなります。
また「2026年時点の最新データ」といった時間軸の特定も容易になるため、タイムリーな回答を求めるプロンプトに対する引用元としても選ばれやすくなります。
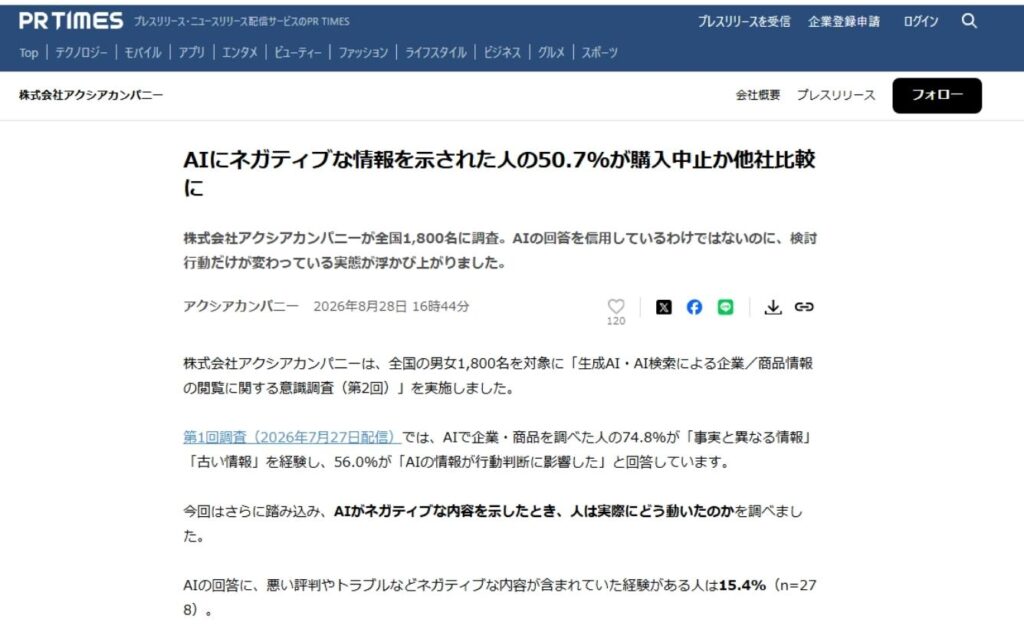
PR TIMESやnoteなどAIでの引用実績が多いドメインから発信する
画像出典:PR TIMES アクシアカンパニー
どれほど質の高い一次情報を用意しても、立ち上げたばかりの自社サイトに掲載するだけでは、AIの回答になかなか引用されません。
生成AIが回答を生成する際は、裏側で検索エンジンを用いてWeb上の情報を取得する仕組み(RAG)が働いていますが、ドメインパワーの弱いサイトは検索結果での露出が低く、AIが情報を拾い上げる対象に選ばれにくい傾向があります。
そこで有効なのが、PR TIMESやnoteといった、すでに検索エンジンから高い評価を受けており、AIサービスによっては引用実績も多い外部プラットフォームの活用です。
検索エンジンからの評価が高い外部ドメインを通じて発信することで、コンテンツがインデックスされやすく、AIが検索で参照元をピックアップするプロセスにおいても拾い上げられやすくなります。
特にPR TIMESのようなプレスリリース配信サービスは、大手ニュースメディアへの転載・引用が発生しやすく、Web上でのサイテーション(言及)が広がるため、AIが「社会的に広く認知された確かなファクト」として判断しやすいメリットがあります。
弊社アクシアカンパニーでも、独自に実施した意識調査などの一次情報は自社サイトに掲載するだけでなく、PR TIMESを活用してプレスリリースとして対外的に発表しています。
自社ドメイン内での公開にとどまらず、初動から検索エンジンに拾われやすい強力なドメインを介して世に送り出すことが、一次情報の到達力を高め、AIに引用される可能性を高める有効なテクニックです。
リソースが少ない企業でもできる一次情報をひねり出すアイデア
一次情報の重要性を理解していても、「大規模な市場調査を実施する予算がない」「検証に割く人員や時間がない」といった制約に直面する企業は少なくありません。
しかし、一次情報とは必ずしも多額の費用をかけたリサーチや専門機関による実験だけを指すわけではありません。
限られたリソースの中でも、独自のファクトをひねり出すための実践的なアイデアを4つ紹介します。
- カスタマーサポートの問い合わせを集計しデータ化する
- 社員の職場インタビューを採用サイトに載せる
- 公式X(旧Twitter)のアンケート機能でフォロワーに質問する
- 公的データなどを再解釈し高品質な二次情報を作る
カスタマーサポートの問い合わせを集計しデータ化する
日々のカスタマーサポートに寄せられる問い合わせや相談の履歴は、外部の競合他社が保有していない貴重な一次情報の宝庫です。
リサーチ会社へ高額なアンケート調査を外注しなくても、自社内に眠っている既存の対応ログを集計・分類するだけで、立派な独自統計データを作成できます。
例えば「過去1年間に寄せられた相談○○件の内訳」や「導入初月にユーザーがつまずきやすいトラブルTOP3」といった形でカテゴリごとに件数や割合を算出し、表やグラフとして整理します。
現場のリアルな声に基づいたデータは机上の推測よりも説得力があり、トラブルシューティングや製品比較を行う読者にとっても実用的な解決策となります。
既存の社内リソースを活用するため、追加予算や工数を抑えつつ、AIに対して現場の生の実態を裏付けるファクトとして認識されやすくなります。
社員の職場インタビューを採用サイトに載せる
画像出典:アクシアカンパニー 採用・求人情報
著名な有識者や外部の専門家にインタビューを依頼すると、多額の謝礼やスケジュール調整のコストが発生します。
しかし、「現場で実際に働く自社の社員」であれば、外部コストを一切かけずに社内リソースだけで純度の高い一次情報を作成できます。
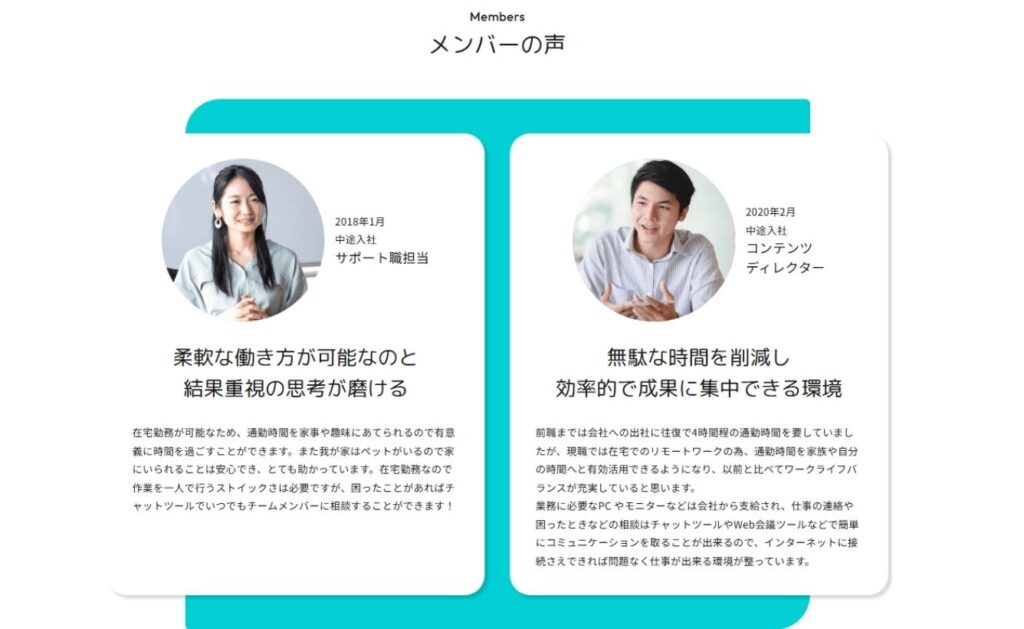
弊社アクシアカンパニーの採用サイトでも、社内メンバーへの職場インタビューを「メンバーの声」として掲載しています。
サポート職やコンテンツディレクターとして働く社員の顔写真や入社時期とともに、現場に身を置く当事者だからこそ語れるリアルな実態を自身の言葉で発信しています。
求職者にとっては、求人票の定型文や外部口コミサイトの噂話よりも、現役社員の具体的な体験談こそが最も信頼できる一次情報です。
特別な予算を投じなくても、社内の身近な声に耳を傾けてコンテンツ化するだけで、他社には真似できない独自の強みを生み出せます。
公式X(旧Twitter)のアンケート機能でフォロワーに質問する
外部のリサーチ会社に調査を依頼すると多額の費用と数週間の納期がかかりますが、公式X(旧Twitter)のアンケート機能を活用すれば、コストを一切かけずに短期間で独自の簡易調査データを収集できます。
自社のフォロワーや業界の関心層に向けて「○○を選ぶ際に最も重視するポイントは?」「○○の機能を使っているか?」といった2〜4択の質問を投げかけるだけで、リアルタイムなユーザーの意識や傾向をパーセンテージとして可視化できます。
集まった投票結果は、投票総数(N数)と実施期間を明記したうえでキャプチャやテキストとしてコンテンツに掲載し、その数値に対する自社ならではの分析や考察を添えることで、立派な一次情報として成立します。
大規模な市場調査と比べるとフォロワー属性による偏りは生じるものの、「いま現場のユーザーがどう感じているか」という最新の生声をスピーディに提示できる点は大きな強みです。
コストやリソースをかけずに、鮮度の高い独自データを素早く打ち出したい場合に効果的なアプローチです。
公的データなどを再解釈し高品質な二次情報を作る
画像出典:Google
自社で予算を投じて独自の市場調査や実証実験を行えない場合でも、官公庁や公的機関が公開しているデータを活用することで、AIに引用される強力なコンテンツを作成することができます。
公的データの「どこの機関が」「いつ発表した」「何の調査データなのか」という引用元を正確に明記したうえで、図解や要約を用いて分かりやすく整理すれば、二次情報であってもAIから信頼できる情報源として評価されます。
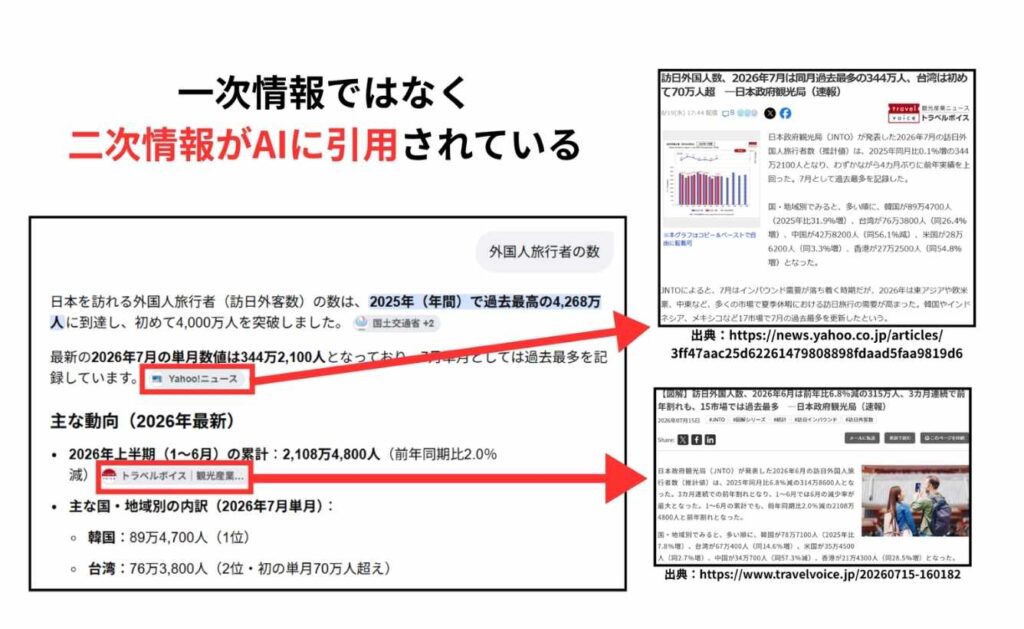
上の図のように、実際にGoogleのAIモードの回答を見ても、必ずしも元の一次情報だけが独占して引用されているわけではないことが分かります。
例えば「外国人旅行者の数」に関する回答では、一次情報の発信元である国土交通省や日本政府観光局の発表だけでなく、その公的データを速報として分かりやすく整理した「Yahoo!ニュース」や「トラベルボイス」の記事も参照元として引用されています。
ゼロから調査を行うリソースがなくても、公的な一次データを正確に引用し、独自の視点や分かりやすい見せ方で再編集することで、AI検索に評価される価値の高いコンテンツを生み出すことができます。
一次情報はAIだけでなくGoogle検索のSEOでも重要となっている
一次情報は、生成AIの回答元として選ばれるためだけでなく、Google検索で評価されるうえでも重要な要素となっています。
AIによる要約や既存情報のまとめ記事がWeb上に溢れかえるなか、Googleも独自性の高いコンテンツを評価する姿勢を明確にしています。
一次情報がGoogle検索のSEOにおいて不可欠とされる理由を解説します。
- E-E-A-TのExperience(経験)を証明する根拠になる
- Googleの「オリジナルコンテンツシステム」で評価される
- 一次情報のないサイトが急落した事例がある
E-E-A-TのExperience(経験)を証明する根拠になる
Googleの検索品質評価ガイドラインで示されている「E-E-A-T」において、2022年末に追加された Experience(経験)は、コンテンツの作成者が実際にそのテーマを体験・実践したかどうかを問う項目です。
生成AIの普及によって誰でもそれらしい一般論やまとめ記事を瞬時に作成できるようになった現在、この「実体験の有無」は、Googleがコンテンツの品質を考えるうえで示している考え方の一つとして位置づけられています。
どれほど流暢で網羅的な解説であっても、Web上の既存情報を集約しただけのコンテンツでは、自身に確かな経験があることを客観的に証明できません。
検証データ、現場で撮影したオリジナルの写真、実務のなかで直面したリアルな失敗や試行錯誤のプロセスといった一次情報こそが、発信者が現場に身を置いて直接検証した動かぬ証拠になります。
一次情報を提示することは、「E-E-A-T」における Experience(経験)を読者や検索エンジンに示すことにつながり、競合記事との差別化の土台となります。
参考:品質評価ガイドラインの最新情報: E-A-T に Experience の E を追加
Googleの「オリジナルコンテンツシステム」で評価される
Googleは検索ランキングのアルゴリズムにおいて、独自性の高いコンテンツを評価する仕組みを公式に導入しています。
Googleの検索セントラルでは、そのシステムについて以下のように明記されています。
オリジナル コンテンツ システム
Google には、独自のレポートなど、独自性の高いコンテンツが、単にそれを引用したものよりも検索結果で上位に表示されて、目立つようにするためのシステムがあります。
このシステムが示している通り、Googleは独自のコンテンツを、それを単に引用・要約したものより優先して検索結果で目立たせる仕組みを持っています。
つまり競合サイトの情報をどれほど網羅的にまとめ直しても、Googleからは「単にそれを引用したもの」と見なされ、長期的に上位を維持することは難しくなっています。
一方で、自社ならではの調査レポートや実測ログ、現場の生データは、コンテンツの独自性を高める有力な方法であり、こうしたシステムで評価される土台となります。
一次情報を組み込むことは、AI検索への対策にとどまらず、Googleのコアな検索システムから正当な評価を得るための根本的なSEO施策と言えます。
一次情報のないサイトが急落した事例がある
AIで量産した網羅的な記事があっても、人間による一次情報がないサイトが検索エンジンのアップデートで淘汰されたという、個人による検証事例があります。
SEO専門家のSEOタイガー氏が公開した検証記事『Claude CodeにSEOを丸投げした180日間の記録』では、同じAIツールでSEOを運用した6サイトのうち、3サイトが右肩上がりに成長した一方、残りの3サイトはアップデートを機にアクセスが約87〜96%も激減しました。
同じAIツールを使ってSEOを運用していた点は全サイト共通でした。
成否を分けた決定的な違いは「AIの出力に、人間の一次情報を乗せたかどうか」です。
失敗したサイトがAIの生成文をほぼそのまま公開する、あるいは方向性を誤った加工をしていたのに対し、成功したサイトはAIの下書きを素材として扱い、現場の実体験や専門知識といった一次情報を人間が加筆していました。
あくまで個人による6サイトの一事例ではありますが、Googleのアップデートを乗り越えて検索順位を維持するうえで、AI任せの記事から脱却し、独自の一次情報を付加することの重要性を示唆しています。
参考:SEOタイガー Claude CodeにSEOを丸投げした180日間の記録【完全版】
一次情報のよくある質問(FAQ)
一次情報の作成や運用を進めるにあたって、現場で生じやすい疑問や懸念をまとめました。
AIの活用範囲やアクセスへの影響など、実務で迷いがちなポイントを解消する参考にしてください。
Q:生成AIを使って「一次情報」を作成することはできますか?
AI自体に、一次情報を作成させることはできません。
生成AIは既存の学習データをもとに確率的にテキストを出力しているに過ぎず、実データを与えずにAIに調査結果を生成させても、もっともらしい架空の数値(ハルシネーション)になりかねず、客観的な一次情報にはならないためです。
ただし、一次情報を作成するための補助ツールとして、AIを活用することは有効です。
例えば、アンケートの質問項目の洗い出し、自社に集まった顧客ログの分類や感情分析、社内インタビュー音声の文字起こしや要点整理など、実務の工数を大幅に圧縮できます。
ファクトとなる元データや実体験は現場から吸い上げ、その整理・分析・可視化のパートナーとしてAIを活用するのが正しい付き合い方です。
Q:一次情報がAIに要約されてサイトへのアクセスが減りませんか?
「~の割合は○○%」といった単純な数値や表面的な事実だけであれば、AIの回答画面上で完結してしまう、いわゆるゼロクリックサーチによって、サイトへの流入が減る側面は確かにあります。
しかし、結果に至る背景や考察、現場の実例まで踏み込んだ内容であれば、AIで概要を知った読者が「さらに詳しく読みたい」とサイトを訪れる動機になります。
また、AIの回答内で信頼できる情報源として自社名やリンクが表示され続けること自体が、強力なサイテーションや指名検索の増加、ブランド認知の獲得につながります。
Q:競合他社がすでに行っている調査や検証でもいいですか?
すでに他社が扱っている似たようなテーマであっても、まったく問題ありません。
むしろ、同じテーマであっても以下の要素が異なるだけで、十分に独自の一次情報として成立します。
| 調査時期の違い | 1〜2年前の古いデータに対し、最新年の実態を捉えたデータはそれだけで高い価値を持ちます。 |
| 調査対象や属性の違い | 一般ユーザー向けではなく「中小企業の担当者」「業界歴10年以上の専門職」など、ターゲットを絞り込むことで独自のデータになります。 |
| 自社独自の比較軸と考察 | 競合が触れていない設問を1つ加える、あるいは現場目線での実践的な考察を付加することで、他社とは異なる結論を提示できます。 |
AIや検索エンジンにとっても、最新の検証データや異なる切り口のファクトは常に必要とされているため、後発であっても十分に引用を狙うことができます。
まとめ:一次情報はAI時代において代替されにくい資産になる
生成AIの普及によって、誰でも短時間でそれらしい記事を作成できる時代になりました。
しかし、Web上の既存情報を単純に再構成しただけでは二次情報の域を出ず、AI検索やGoogle検索において差別化することは難しくなります。
現場で検証した者にしか生み出せない一次情報は、コンテンツの独自性を高める有力な手段です。
この記事も、弊社の独自調査データや採用サイト、対策事例といった実例を多分に織り交ぜて解説してきたように、一次情報は自社の足元にあるファクトを掘り起こすことで生み出せます。
AIに代替されるまとめ記事から脱却し、自社ならではの実体験や独自データをコンテンツとして積み重ねていくことが、AI引用の獲得と持続的なSEO評価を両立させる、強固なWeb資産となります。