ブランドLLMO
 逆SEO対策
 サジェスト対策
 採用ブランディングサービス

ChatGPTやGeminiのような生成AIの普及により、ユーザーはWebサイトを訪問する前に、AIとの対話画面で企業や商品を比較・選別する時代を迎えました。
しかし、AIが常に最新かつ正確な公式情報を語ってくれるとは限りません。
Web上に残る古いデータや断片的な口コミが参照され、事実無根の悪評や誤った情報が出力されることで、企業が気付かないうちに採用辞退や商談見送りにつながるおそれのある「AI風評リスク」が高まっています。
株式会社アクシアカンパニーが実施した独自調査では、ユーザーの過半数がAIを情報収集に利用しており、その7割以上が誤情報に直面、さらに半数以上がAIの回答を行動の判断材料にしている実態が明らかになりました。
本記事では、この調査データをもとにAIが誤情報を出力する構造的な原因やリスクを紐解きます。
また、AIに自社を正しく認識・引用させるためのLLMO対策(大規模言語モデル最適化)の具体的な手法まで解説します。
関連記事
・LLMOとは?対策のやり方・SEOとの違い・費用までわかりやすく解説
・採用LLMOとは?AIに選ばれ、悪評で候補から外れないための対策
・生成AIはなぜ誤答する?ChatGPTの嘘の原因・悪影響・風評対策を解説
ブランドLLMO対策の
仕組み・導入実績を知りたい方
簡単1分!サービス内容をチェック
【独自調査】生成AI・AI検索で企業情報を調べる実態
生成AIやAI検索の普及により、消費者が企業や商品をリサーチする手段は従来の検索エンジンから大きく変化しています。
株式会社アクシアカンパニーが全国の男女1,587名を対象に実施した「生成AI・AI検索による企業/商品情報の閲覧に関する意識調査」では、多くの人が日常的なリサーチ手段としてAIを活用している実態が浮き彫りとなりました。
また、出力される回答の正確性や、回答内容がユーザーの行動に及ぼす影響についても課題が明らかになりました。
独自調査のデータをもとに、最新のAIの利用実態を紐解きます。
過半数が企業や商品をAIで検索・リサーチしている
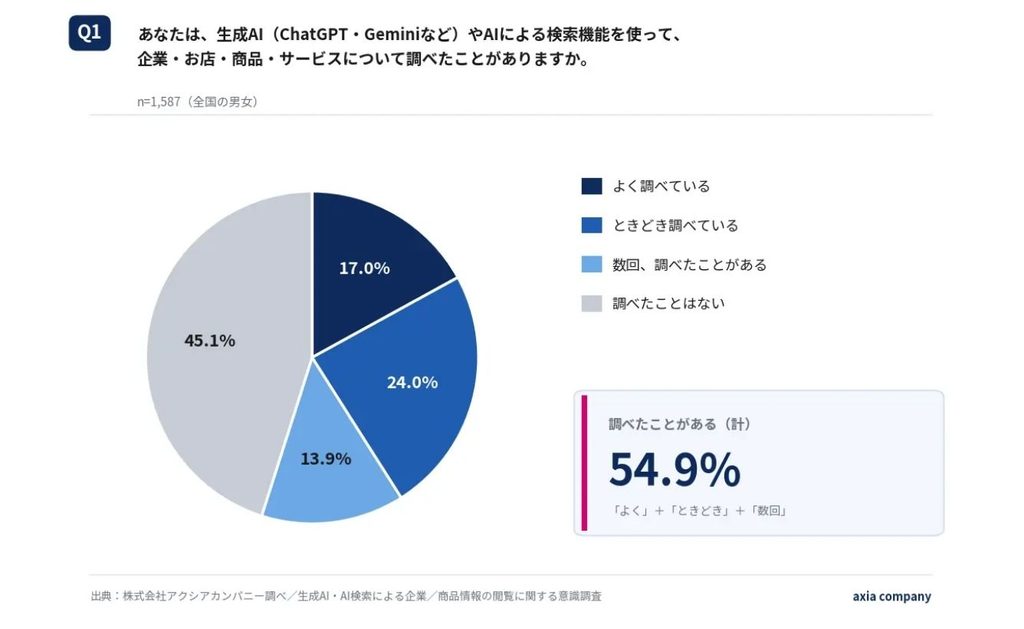
企業や商品、サービスの情報収集において、生成AIやAI検索を活用する生活者はすでに過半数に達しています。
弊社(アクシアカンパニー)の独自調査において、「生成AI(ChatGPT・Geminiなど)やAIによる検索機能を使って、企業・お店・商品・サービスについて調べたことがありますか」と質問したところ、以下のような結果となりました。
| 回答 | 割合 |
| よく調べている | 17.0% |
| ときどき調べている | 24.0% |
| 数回、調べたことがある | 13.9% |
| 調べたことはない | 45.1% |
調査の結果、「よく調べている(17.0%)」「ときどき調べている(24.0%)」「数回、調べたことがある(13.9%)」を合わせると「54.9%」となり、すでに半数以上の生活者がAIをリサーチ手段として利用している実態が明らかになりました。
また「よく調べている」と「ときどき調べている」を合わせた日常的な利用層だけでも「41.0%」と4割を超えている点が注目されます。
従来の検索エンジンのように複数のWebサイトを見比べる行動から、AIに対話形式で質問し、瞬時に要約された回答を受け取る行動へのシフトが急速に進んでいます。
購入や利用の検討段階でAIの回答に接触することが一般化した現在、AIに自社がどう認識され、どう回答されているかは企業にとって無視できない要素と言えます。
利用者の74.8%がAI回答の「誤り・古い情報」に直面
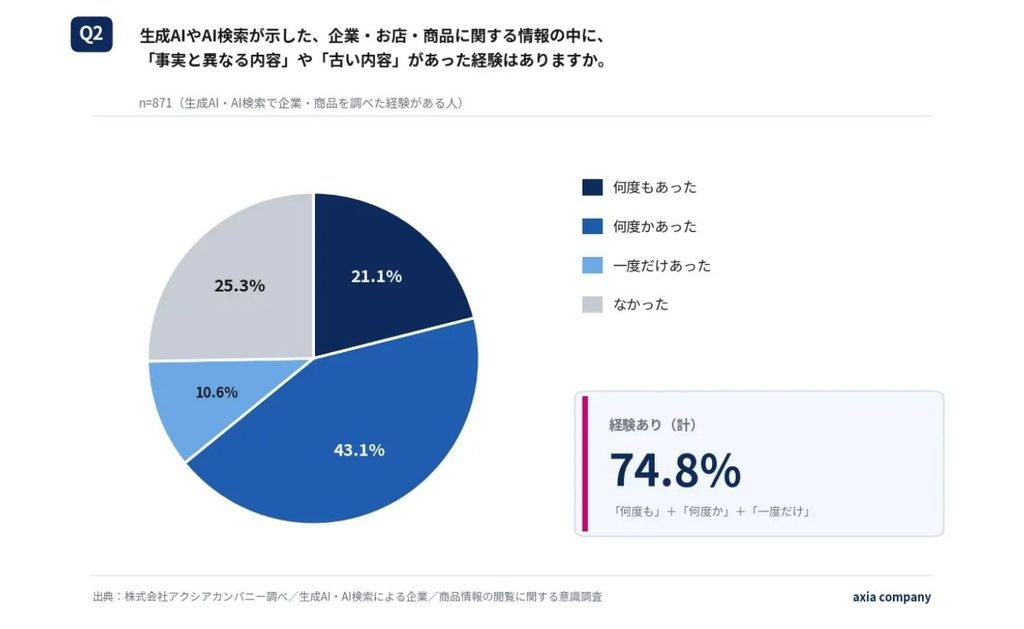
AIを通じて企業や商品情報を調べたユーザーのうち、「74.8%」の人が誤った情報や古い情報に直面した経験を持っています。
弊社(アクシアカンパニー)の独自調査において、「生成AIやAI検索が示した、企業・お店・商品に関する情報の中に、『事実と異なる内容』や『古い内容』があった経験はありますか」と質問したところ、以下のような結果となりました。
| 回答 | 割合 |
| 何度もあった | 21.1% |
| 何度かあった | 43.1% |
| 一度だけあった | 10.6% |
| なかった | 25.3% |
調査の結果、「何度もあった(21.1%)」「何度かあった(43.1%)」「一度だけあった(10.6%)」を合わせると「74.8%」に達し、大多数の利用者がAIの回答内容に誤りや情報の古さを感じていることが分かります。
特に注目すべきは、「何度もあった」「何度かあった」と回答した層だけでも「64.2%」に達している点です。
つまり、一度きりの例外的な事象にとどまらず、日常的なリサーチの中で誤情報への接触が常態化している実態がうかがえます。
AIはもっともらしい文章でユーザーの質問に答えようと回答するため、古い情報や誤った事実が生成され誤解を招くリスクがあります。
もしも誤った自社情報がAIによって提示され続ければ、機会損失や企業信用の失墜に直結しかねません。
AIに自社の正確な一次情報を認識させる取り組みが、現代の企業防衛において不可欠となっています。
56.0%が「行動の判断に影響した」と回答
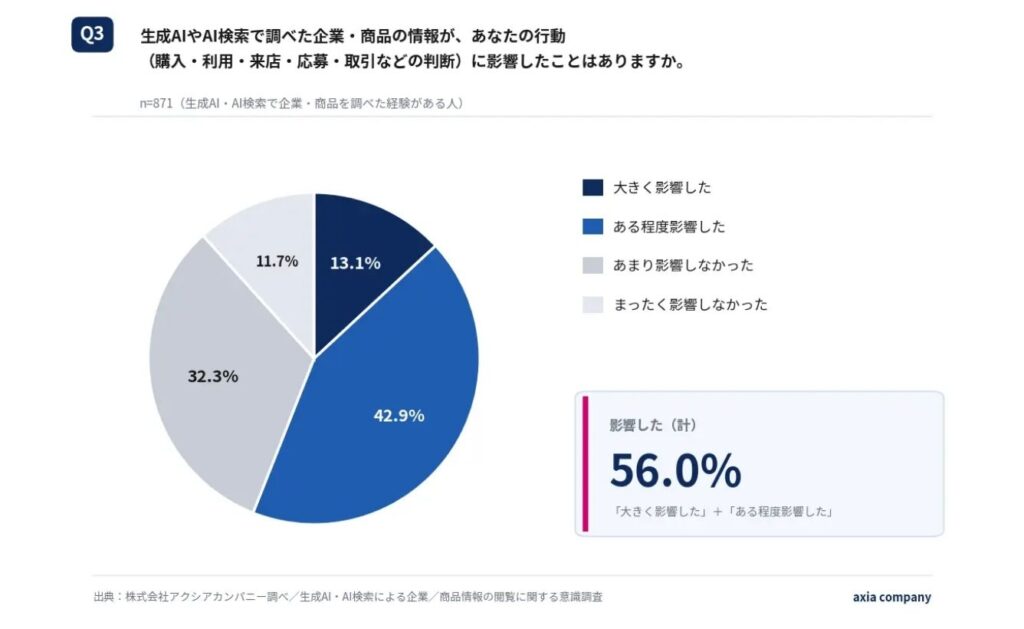
生成AIやAI検索が提示した企業・商品情報は、「56.0%」のユーザーの実際の行動判断に影響を与えています。
弊社(アクシアカンパニー)の独自調査において、「生成AIやAI検索で調べた企業・商品の情報が、あなたの行動(購入・利用・来店・応募・取引などの判断)に影響したことはありますか」と質問したところ、以下のような結果となりました。
| 回答 | 割合 |
| 大きく影響した | 13.1% |
| ある程度影響した | 42.9% |
| あまり影響しなかった | 32.3% |
| まったく影響しなかった | 11.7% |
調査の結果、「大きく影響した(13.1%)」と「ある程度影響した(42.9%)」を合わせると「56.0%」となり、半数以上の生活者がAIの回答を行動の判断材料としている実態がうかがえます。
AIの回答が単なる参考情報にとどまらず、購買や来店、採用応募、取引といった具体的な行動の意思決定を直接左右しています。
認知から意思決定までのプロセスでAIが果たす役割が高まる中、AIが参照する情報の最適化は企業の業績に直結する重要課題と言えます。
なぜAIは「誤った情報」や「古い情報」を出力してしまうのか?
AIが事実と異なる回答や古い情報を出力してしまう背景には、生成AIの情報収集および回答生成プロセスにおける構造的な問題が存在します。
独自調査でも7割以上の利用者が誤った情報や古い情報に接した経験があると回答していますが、これはAIがネット上の膨大なデータを処理する過程で生じる「参照元の選定」や「特有の技術的制約」に起因します。
AIが誤情報を生成してしまう3つの根本的な原因を解説します。
- 過去のWebメディアの情報を学習・参照することがある
- ハルシネーション(もっともらしい嘘)と情報の断片化
- 公式サイトの一次情報がAIに認識されにくい構造になっている
過去のWebメディアの情報を学習・参照することがある
AIが誤った情報や古い情報を出力してしまう原因の一つは、過去に公開されたWebメディアの古い記述をそのまま参照・学習してしまう点にあります。
現在主流となっているAI検索機能には、RAG(検索拡張生成)という技術が広く使われています。
RAGはユーザーの質問に応じてWebサイトやデータベースなどから関連情報を取得し、その情報を参照して回答を生成する仕組みです。
しかし、このRAGが必ずしも企業の「最新かつ正確な公式情報」を優先的に抽出するとは限りません。
Web上には数年前に公開された記事や、個人の古い口コミ・レビューなどが大量に残っています。
検索エンジン側でそれらの過去コンテンツが上位に評価されていたり被リンクを多く集めていたりすると、AIは情報の鮮度を正確に判別できず、古い内容を信頼できるソースとして採用してしまうことがあります。
その結果、すでに変更された料金体系や終了したキャンペーン、過去のトラブルといった情報が、現在進行形の実態として出力され続けてしまうことがあるのです。
ハルシネーション(もっともらしい嘘)と情報の断片化
AIが誤った情報を出力してしまう要因として、「ハルシネーション」と呼ばれる虚偽情報の生成と、ネット上に散らばる情報の断片化が挙げられます。
生成AIは事実を論理的に理解しているのではなく、確率的に自然な単語の並びを予測して文章を構築しています。
そのため、参照データの中に確実な正解が存在しない場合であっても、あたかも真実であるかのような「もっともらしい嘘」を滑らかな文章で出力してしまう本質的な弱点を持っています。
そして、これに拍車をかけるのが情報の断片化です。
AIが複数のWebサイトから取得した情報をもとに回答を生成する際、異なる情報を混同したり、文脈を誤って解釈したりすることがあります。
その過程で、同名の別企業の情報と混同されたり、無関係な情報が誤って結びつけられたりする現象が起こります。
バラバラな情報が誤った因果関係で再構築されることで、事実無根の悪評や歪められた実態が、AIの回答として定着してしまうのです。
公式サイトの一次情報がAIに認識されにくい構造になっている
公式サイトがAIに認識されにくい構造になっていると、AIが公式外の二次情報を読み取る確率が高まり、結果として不正確な回答を出力する原因となります。
AIは回答を生成する際、信頼性が高く、読み取りやすいデータを優先して取得する傾向があります。
例えば、以下のようなケースではAIが正しい情報を取得しにくくなる可能性があります。
正しい一次情報が届かない結果、AIはネット上に散らばる古い口コミやまとめ記事を頼りに回答を組み立ててしまいます。
AIに正しく自社を語らせるためには、公式サイトを「AIが理解しやすい構造」へと整備することが重要です。
放置は危険!企業が直面するAI風評リスク
AIによる誤情報やネガティブな回答を放置することは、企業の事業活動に深刻な実害を招く可能性があります。
AI検索がユーザーの意思決定に直結する現在、事実無根の悪評や古い情報が出力され続けると、企業の社会的信用や売上に悪影響が出ます。
放置することで企業が直面する3つのAI風評リスクを解説します。
採用活動への悪影響
AI検索による誤情報やネガティブ情報の出力は、求職者のサイレント辞退を招き、企業の採用活動に深刻な打撃を与えます。
就職や転職活動を行うユーザーは、企業リサーチにおいて複数の口コミサイトを確認する代わりに、AIに対して企業の労働環境や社風を端的に要約させます。
- 企業名と共に「実際の働きやすさ」や「離職率の実態」など、AIに対話形式で質問する
- AIが過去の断片的な口コミを参照し、「残業が多い」「すぐ辞めていく」といった要約を出力する
- 真偽を確かめずに「この企業はやめておこう」と応募見送りや選考辞退を静かに決断する
このプロセスにおいて問題なのは、求職者が企業側に一切の理由を告げずに離脱していく点です。
企業側はエントリー数の低下や内定辞退率の悪化に悩みながらも、AIの回答が原因であることに気づけません。
どれほど採用広報に予算を投じても、最初の情報接点であるAI検索で候補者を失ってしまうリスクがあります。
信頼失墜・IRや取引先審査への悪影響
AIによる誤情報やネガティブ情報の出力は、企業の社会的信用を大きく毀損し、新規取引の停止や投資機会の喪失といった致命的な経営リスクに直結します。
今後、企業の与信管理やコンプライアンス審査、投資判断の初期リサーチにおいて、情報収集の効率化を図る目的でAIを活用する流れが強まっていくと考えられます。
審査担当者や投資家がAIに企業のリスク調査を尋ねた際、過去の一過性のトラブルや事実無根の風評が要約されてしまうと、深刻な事態を招きます。
例えば、コンプライアンス審査の段階で「過去に不祥事の疑いがある」と誤認され、取引の開始が一方的に見送られる可能性が考えられます。
また、すでに解決済みの労務問題や古い訴訟情報が現在進行形のリスクとして出力されれば、金融機関からの与信評価が下がり、融資条件に悪影響を及ぼしかねません。
さらに、投資家のリサーチ段階でネガティブな要約が提示されると、出資や株式購入の判断が見送られる可能性があります。
AIが語る自社情報が、経営基盤を揺るがす深刻な信用失墜を招く危険性があります。
購買・問い合わせのステルス失注
AIによる誤情報やネガティブな出力は、見込み顧客が自社サイトを訪れることなく検討から離脱する「ステルス失注」を引き起こします。
現在、商品やサービスの購入を検討するユーザーの多くは、AIに対して「〇〇サービスの評判は?」「競合他社との違いやデメリットは?」といった質問を投げかけます。
その際、AIがネット上の古い不満レビューを引用し、「サポート対応が遅い」「費用対効果が低い」といった要約を提示してしまうと、ユーザーは公式サイトを確認することすらなく、その場で他社へ乗り換えてしまうリスクがあります。
これが企業にとって深刻なのは、すべてのプロセスがAIの回答画面上で完結してしまう点にあります。
アクセス解析ツールや広告のレポートには痕跡が残りにくいため、マーケティング担当者や営業担当者は「なぜか問い合わせが減っている」と頭を抱えながらも、AIの誤情報が原因である事実にすら気づけません。
水面下で売上機会が奪われ続けるステルス失注を防ぐためにも、AIがユーザーに自社をどう語っているかを把握し、早急に対策を打つ必要があります。
ブランドLLMO対策の
仕組み・導入実績を知りたい方
簡単1分!サービス内容をチェック
AI検索時代に企業が取るべきLLMO対策
AI検索が普及し、回答の誤情報による風評被害が現実の脅威となった今、企業が講じるべき解決策の一つがLLMO対策です。
従来の検索エンジン対策であるSEOだけでは、AIがどの情報を参照し、どのような文脈で回答を出力するかをコントロールすることはできません。
新たな防衛・情報戦略となるLLMOの定義と、従来のSEOとの明確な違いを解説します。
- LLMOとは?
- LLMOとSEOとの違い
LLMOとは?
LLMO(大規模言語モデル最適化)とは、ChatGPTやGeminiなどのLLMに対し、自社に関する情報が正確かつ適切に参照・回答されるようWeb上の情報を最適化する施策のことです。
従来のSEOが検索エンジンの表示順位を競うものであるのに対し、LLMOはAIという回答エンジンに自社の一次情報を正しく理解させ、誤認やネガティブな要約を防ぎながら適切な推奨を獲得することを目指します。
近年は、AI関連のマーケティング用語が複数登場しており、文脈に応じて以下のように使い分けられています。
| LLMO(大規模言語モデル最適化) Large Language Model Optimization | 対話型AIやAI検索を含むLLM(大規模言語モデル)全般を対象に、自社情報の正確な認識・引用・好意的な推奨を促す取り組み |
| GEO(生成エンジン最適化) Generative Engine Optimization | 生成AIによる検索・回答プロセスにおいて、自社情報が信頼できる参照元(引用ソース)として選定・提示されることを目指す施策 |
| AIO(AI最適化) AI Optimization | AI技術全般を用いた情報設計の最適化を指す包括的な概念、またGoogleの「AI Overviews対策」の略語のように限定的な意味で使われるケースも稀にある |
それぞれ細かな違いはあるものの、「AIに自社の存在と価値を正しく出力させる」という本質は共通しています。
そのため、現段階では言葉の定義の差異を深く意識しすぎる必要はありません。
LLMOとSEOとの違い
検索エンジンを前提としたこれまでのSEOと、大規模言語モデルを前提としたLLMOの違いを整理すると、以下のようになります。
| SEO | LLMO | |
| 対策対象 | 検索エンジン(GoogleやYahoo!) | LLM(ChatGPTやGemini) |
| 最終目的 | 検索結果の上位表示と自社サイトへの流入獲得 | AI回答内で正確な情報を提示してもらい、参照・引用元として選ばれること |
| 評価される要素 | キーワードの検索意図を満たしているか 被リンク数 サイト全体のドメインパワー | 一次情報の明確さや信頼性 テキストの論理構造 Web上の言及量 |
| 放置した際のリスク | 検索順位の下落によるWebトラフィックの減少 検索ユーザーの認知低下 | 誤情報や事実無根の悪評が定着することによる風評被害 AI検索ユーザーの認知低下 |
SEOが「検索エンジンに評価されてアクセスを集める」ための施策であるのに対し、LLMOは「AIに正しい一次情報を認識させ、信頼できる根拠として引用させる」ための施策です。
検索結果から自社サイトへ誘導するアプローチだけでなく、AIの回答画面上で自社が正確に言及・参照されやすい状態を整える情報設計が、今後のWeb集客において重要になってきています。
SEOだけでは企業の信用を守れない理由
検索エンジンの上位表示を維持していれば自社の信頼や集客を担保できた時代は、AI検索の普及によって終わりを告げつつあります。
これは、ユーザーの情報探索行動が変化したためです。
またAIには、従来の検索キーワードにとらわれない、独自の文脈判断で情報を解釈・選定する仕組みがあります。
従来のSEOだけでは対応しきれない構造的な理由を解説します。
- ゼロクリック検索の定着
- 「検索1位=AIが推薦してくれる」とは限らない
- 対話型・比較プロンプトによるキーワード対策の限界
ゼロクリック検索の定着
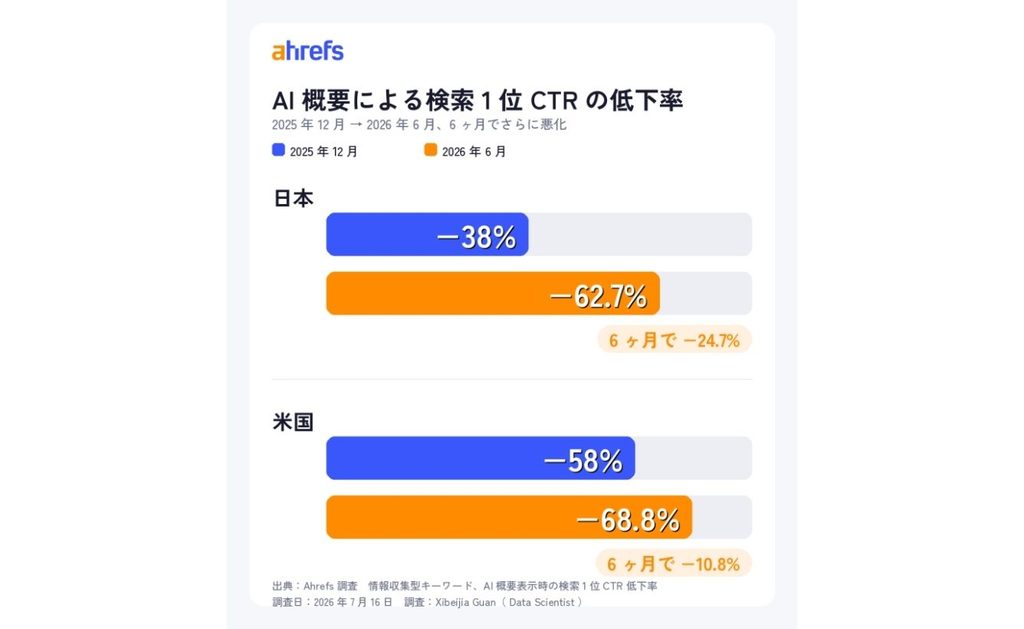
画像出典:Ahrefs AI 概要で Google 検索 1 位の CTR が半年で激減、日本 クリック率が − 62.7% に減少
検索結果の最上部にAIが回答提示するGoogleの「AI Overviews」によって、Webサイトを訪問せずに探索を完結させる「ゼロクリック検索」が急速に定着し、「検索1位=Web流入」という前提が崩壊しつつあります。
SEOツール大手のAhrefsが公表した調査によると、情報収集型キーワードにおいて「AI Overviews」が表示された際の検索1位のクリック率低下率は、日本国内で2025年12月の「−38%」から2026年6月には「−62.7%」へと大幅に悪化しました。
実測のクリック率も9.0%にとどまっており、ユーザーのクリック離れは一過性ではなく現在進行形で加速していることが分かります。
ユーザーがWebサイトを訪問しなくなった結果、自社サイト内に正確な一次情報を掲載していても、AIの要約に誤りやネガティブな風評が含まれていれば、それがそのまま事実として認識されてしまいます。
自社サイトへの流入を前提とする従来のSEOだけでは、AIの回答画面上で意思決定が完結する環境において、自社の信用を守りきることは困難です。
「検索1位=AIが推薦してくれる」とは限らない
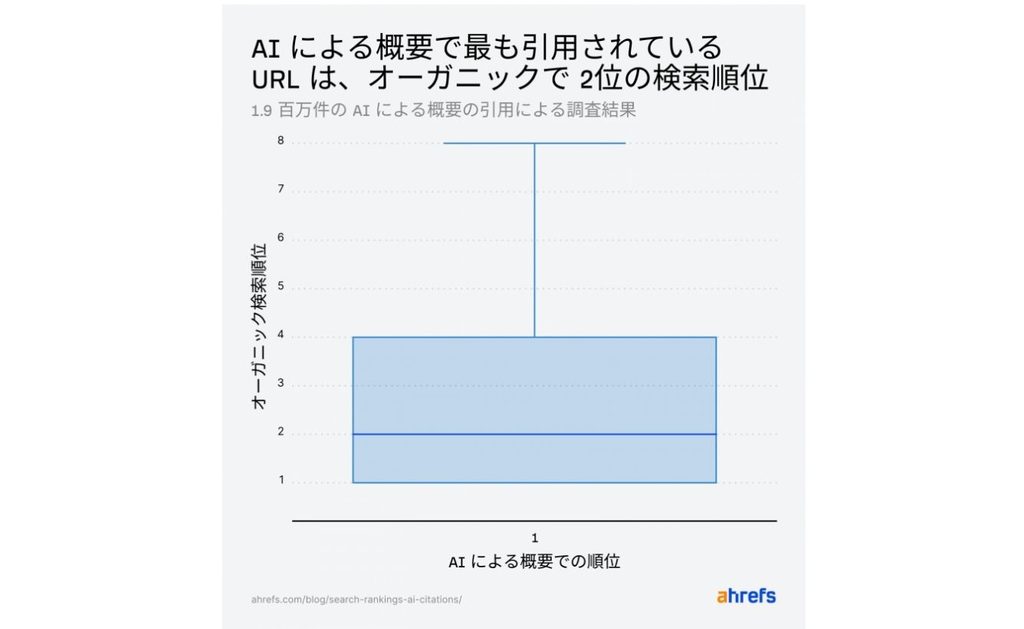
画像出典:Ahrefs AI による概要で引用される方法:データが示す「本当に効く施策」
検索エンジンの上位表示はAIに参照されるための重要な要素であるものの、「検索1位を獲得していればAIが自社を最優先で推薦してくれる」とは限りません。
Ahrefsが190万件の「AI Overviews」における引用データを分析した調査によると、引用されたURLの76%は従来のオーガニック検索でも上位10位以内にランクインしていました。
この結果から、従来の検索結果で上位に表示されているページは、AI Overviewsでも引用されやすい傾向がうかがえます。
しかし注目すべきは、AI Overviewsの1番目に引用されたURLの検索順位の中央値が「2位」である点です。
つまり、検索上位を維持することはAIの参照候補に入るための前提条件に過ぎず、1位のページが無条件に最も引用・推奨されるわけではありません。
従来のSEOであれば、検索1位さえ獲得すれば圧倒的なクリック率によって自社の正確な一次情報を見てもらえました。
しかしAI検索の世界では、かつてのような「検索1位の絶対的価値」は通用しません。
対話型・比較プロンプトによるキーワード対策の限界
特定の単一キーワードに対してページを最適化する従来のSEOでは、ユーザーが多様な文脈や条件を指定して問いかける「対話型・比較プロンプト」に対応しきれません。
これは検索の起点が単語の入力から、文脈を持った対話へと根本から変化したためです。
| ユーザーの入力内容 | 入力後の行動 | |
| キーワード検索 | 「○○ おすすめ」 「5万以下 ○○ おすすめ」 | せいぜい2〜3単語の組み合わせで検索し、 検索結果のおすすめ記事から気になった場合に、別途公式サイトを訪問する |
| プロンプト入力 | 「予算5万円で、○○と○○と○○があって、~にも対応していて、口コミの評判がいいものは?」 | 一度で理想の条件を網羅した指示を出し、 AI回答内で情報選別を完結させ、その後最終確認として公式サイトに訪問する |
従来は、比較記事などを経由して公式サイトを訪れたユーザーに対し、一次情報を提示して信用を築く余地がありました。
しかしAI検索では、AI自身がユーザーの細かい要求に応じてWeb上の情報を照合し、回答画面の中で比較や選別を完結させてしまいます。
自社に関する正確な一次情報がAIに正しく認識・引用されていなければ、ユーザーが最終確認として公式サイトを訪れる前の段階で、誤った情報や偏った評判をもとに選考から除外されかねません。
特定キーワードの順位獲得に頼る従来のSEOだけでは、多様な文脈を理解するAIの選別プロセスから淘汰されてしまいます。
AIに自社を正しく認識・引用させるためのLLMO対策
AI検索において自社を正しく認識させ、引用を獲得するためには、LLMO対策が不可欠です。
AIは情報の信頼性や理解しやすい構造、Web全体における客観的な評判などを総合的に判断して回答を生成しています。
それらAIの特有のプロセスを踏まえ、LLMO対策の具体的な3つの手法を解説します。
E-E-A-Tを含む一次情報の強化
生成AIの回答では、検証可能で出所の明確な情報が、回答の根拠として活用されやすいと考えられます。
つまり、Web上の一般的な解説や抽象的なスペック情報だけを提示していては、AIに信頼できる情報源として選定されず、誤った回答の生成や推奨からの除外につながりかねません。
AIから正しく認識され、引用を獲得するためには、企業自らが事実の出所となる一次情報を発信し続ける必要があります。
具体的には、以下のような一次情報が求められます。
AIに「この分野において最も確からしい情報の起点」として認識させる体制を整えることが、ハルシネーションによる誤認リスクを防ぎ、企業の信用を獲得するための大前提となります。
AIが引用・要約しやすいコンテンツ設計
前述した「公式サイトがAIに認識されにくい構造」を解消し、AIに自社の情報を正しく引用・要約させるためには、文章そのものの書き方をAIが解釈しやすい形式に整える必要があります。
AIはテキストを機械的に解析して回答を生成するため、前後の文脈に頼った曖昧な記述は誤読や要約時の誤認を招く原因になります。
AIが情報を正確に抽出し、回答のソースとして扱いやすくするためのポイントは以下の通りです。
- 冒頭で要点を述べる結論ファーストの文
- 1文に2つ以上の結論を述べない「一文一義」の徹底
- 「これ」「それ」といった指示語を排した、主語や固有名詞の明示
- 条件や比較データをひと目で照合できる表や箇条書きの活用
AIに文脈を推測させる余地を減らし、単独の文章でも事実関係が明確に伝わる論理的な記述を徹底することが、意図通りの引用や推奨につながります。
自社ドメイン外における言及の獲得
AIによる引用を獲得するためには、自社サイト内の整備にとどまらず、外部のメディアやプラットフォームを活用してWeb上での言及(サイテーション)を増やすことも重要です。
Web上での言及が増えることは、情報の信頼性の裏付けとなるだけでなく、AIがWeb上のさまざまな情報を参照する性質上、AIの参照ソースとして拾われる確率そのものを高める効果もあります。
自社ドメイン外での言及を増やすための主なアプローチは以下の通りです。
- PR TIMESのようなプレスリリースサイトでの配信
- Webメディアへの寄稿・インタビュー出演
- noteのようなドメインの強いプラットフォームでの発信
自社サイトの外側にも客観的な事実や信頼の証拠を分散して蓄積しておくことで、AIの参照対象に選ばれやすくなり、好意的な引用につながります。
自社がAIにどう評価されているか?LLMO診断・モニタリングの進め方
AI検索において自社がどのように認識され、競合と比較してどう推奨されているかを把握するには、従来の検索順位チェックとは異なるモニタリングが必要です。
自社に対するAIの評価や誤認リスクを正確に可視化し、適切な改善につなげるための手順を解説します。
- 主要AIエンジンを横断した定点調査
- 自社の評価や課題を多角的に把握するプロンプト
- ネガティブな回答が出たら参照元URLの特定・裏取り
主要AIエンジンを横断した定点調査
AIによる自社の評価や推奨状況を把握する際は、単一のツールだけでなく、複数の主要AIエンジンを横断して調査する必要があります。
これは、AIごとに参照するデータソースや検索アルゴリズム、情報の優先順位などが多少異なるためです。
例えば、Googleの検索インデックスを基盤とするAIと、独自のWeb検索や学習データを優先する対話型AIとでは、同じプロンプトを入力しても推奨される内容が異なる可能性があります。
モニタリングの対象として押さえておくべき、主要なAIエンジンは以下の通りです。
あるAIでは正確に評価されていても、別のエンジンでは古い情報が回答されたり、競合他社が優先して推奨されたりすることも珍しくありません。
また、AIの出力はWeb上の言及やモデルの更新によって日々変動します。
一度の確認で終わらせず、同一条件での調査を定期的に行い、自社の認識状況や評価の推移を定点観測し続ける体制が不可欠です。
自社の評価や課題を多角的に把握するプロンプト
AIが自社をどのように理解・評価しているかを正確に把握するには、社名を入力するだけでなく、ユーザーが実際に行う比較や相談の文脈を再現したプロンプトを投げかける必要があります。
角度を変えて問いかけることで、AIの認知度や他社との差別化要素、潜在的な誤認リスクを網羅的にあぶり出せます。
検証時に用いるプロンプト例を紹介します。
| 指名検証 | 「〇〇(自社・サービス名)の特徴、強み、料金体系を教えて」 |
| 業界推薦 | 「〇〇業界でおすすめのサービスを3つ挙げて、選定基準も解説して」 |
| 競合比較 | 「〇〇(自社)と××(競合)の違いや、それぞれの向き・不向きを比較して」 |
| 風評検証 | 「〇〇(自社)の評判やデメリット、注意点を客観的に教えて」 |
これらのプロンプトを横断して実行し、自社が推奨候補に含まれているか、事実無根のネガティブな情報が出力されていないかを検証することが重要です。
ネガティブな回答が出たら参照元URLの特定・裏取り
AIの出力結果に事実無根のネガティブな情報や古いデータが含まれていた場合、直ちにAIが参照した元ソースを特定し、事実確認を行う必要があります。
現在、多くのAIエンジンではRAG(検索拡張生成)の仕組みによって、回答とともに根拠となった出典リンクやURLが提示されるため、どのWebページをもとに回答が生成されたかを追跡することが可能です。
画面上にリンクが表示されない場合は、追加プロンプトで参照元の提示を求める方法もあります。
ただし、実際に参照したURLとは限らないため、提示された情報の裏取りが必要です。
参照元を突き止めた後は、それが自社サイト内に残る古い記述なのか、それとも外部メディアの誤記や口コミサイトの偏った情報なのかを精査します。
| 自社サイトの情報 | 古い記述や曖昧な表記の修正・更新 |
| 外部メディアの言及 | 事実無根なら削除・訂正を要請する、対応してもらえない場合、その内容を訂正する正確な一次情報を自社サイトに載せる |
AIの誤認を放置せず、参照元という「情報の大元」を正すアプローチこそが、企業の信用毀損を防ぐ確実な防衛策となります。
AIの誤認・悪評の原因となる危険な参照元サイト
AIはWeb上のさまざまな情報を参照して回答を生成するため、信憑性の乏しいプラットフォームや個人の感情的な投稿まで参照ソースとして取り込んでしまうリスクを常に抱えています。
AIがこれらを「客観的なユーザーの声」や「事実関係」として誤認・要約すると、回答画面上で事実無根の悪評や偏った企業イメージが出力され、信用毀損に直結します。
AIによる誤認やネガティブな評価を引き起こす原因につながりやすい代表的な参照元サイトの例を紹介します。
過去の不満が根強く残る転職口コミサイト
転職口コミサイトは、退職者や元社員による不満、個人的な感情を含むネガティブな意見が集まりやすいプラットフォームです。
数年前の古い労働環境や既に改善された待遇に関する記述であっても、Web上に残り続けている限り、AIは「現在も続く企業の内部実態」や「客観的なデメリット」として要約・引用してしまうリスクがあります。
代表的な転職口コミサイトには、以下のようなものがあります。
- OpenWork
- エン カイシャの評判
- 転職会議
- Indeed
- キャリコネ
これらのサイトに書き込まれた過去の不満をAIが最新の企業実態として定着させてしまうと、採用活動にとどまらず、企業ブランド全体の毀損に直結します。
個人の主観や誹謗中傷の多い匿名掲示板・Q&Aサイト
匿名掲示板や知恵袋などのQ&Aサイトは、根拠のない憶測や個人の主観、時には悪意ある誹謗中傷が集まりやすいプラットフォームです。
これらの信憑性の低いテキストであっても、AIが「一般的な世論」や「リアルな声」として抽出すると、ネガティブな回答になりかねません。
AIが悪評や誤認の参照元として拾う可能性のある具体的なサイトは、次の通りです。
- 5ちゃんねる(旧2ちゃんねる)
- 爆サイ.com
- Yahoo!知恵袋
事実無根の書き込みであってもWeb上に放置されていると、AIによって企業の潜在的なリスクや悪評として回答に定着しかねません。
PV目的で作られた炎上まとめブログ
PV獲得や広告収入を目的に運営されるまとめブログは、閲覧数を稼ぐために過激な見出しを掲げ、SNS上の噂や断片的な情報を歪曲して掲載する傾向があります。
事実確認を経ないまま投稿された憶測記事や、過去のトラブルを切り抜いたコンテンツであっても、Web上に残り続けている限りAIが「世間で注目されているトラブル事例」として参照してしまうリスクを伴います。
こうした低品質なまとめ記事の情報をAIが学習・参照してしまうと、回答画面上で事実無根の悪評が定着し、企業の信頼性やブランドイメージに甚大な被害を及ぼしかねません。
いずれの参照元も、事実無根の書き込みや古い情報がWeb上に残り続ける限り、AIの回答に影響を与えかねません。
定期的なモニタリングで早期に火種を特定し、悪質な投稿への削除申請や、公式サイトを通じた正確な一次情報の発信によって、AIが参照すべき「正しい事実」を提示しておくことが重要です。
ブランドLLMO対策の
仕組み・導入実績を知りたい方
簡単1分!サービス内容をチェック
LLMO対策は自社でできる?専門業者へ外注すべき判断基準
LLMO対策は、自社サイト内のテキスト改修にとどまらず、Web全体の言及状況の改善やAIエンジンの挙動解析など、専門的な知見が求められます。
そのため、自社だけで完結させるのか、専門会社へ外注するのかの切り分けが重要です。
どのようなケースで、どちらを選ぶべきなのか、判断の目安を整理します。
- 自社で対応できること
- 自社だけでは限界があり、外注すべきこと
自社で対応できること
自社リソースで対応できる領域は、主に公式サイト内の情報修正・追記、そしてモニタリングによる現状把握です。
社内ですでに把握している事実関係の整理や、公開済みページの文言修正であれば、外部コストをかけずに迅速に着手できます。
自社で対応可能な主な作業は、以下の通りです。
放置されている過去の情報を最新化し、AIに誤解されやすい表現を修正し、一次情報を補足することは、最低限の守りの対策として社内でも十分に実行可能です。
しかし、これらはあくまで既存サイト内の歪みを整える作業にとどまります。
自社だけでは限界があり、外注すべきこと
自社のリソースだけで完結させることが難しい領域は、AIに参照・引用されるための攻めのコンテンツ戦略です。
前述のLLMO対策(一次情報の強化、AIが引用・要約しやすいコンテンツ設計、自社ドメイン外での言及の獲得)は、いずれも単発ではなく継続的な運用が前提となります。
自社だけで取り組む場合、主に以下の点で限界が生じやすくなります。
Web上に多面的に展開された客観的事実や、信頼性の高い統計データは、回答の根拠として参照されやすい傾向があります。
社内サイトの微修正にとどまらず、AIに参照・引用されるための根拠となる一次情報源をWeb全体で構築していく設計こそが、専門業者に外注すべき判断基準となります。
LLMOに関するよくある質問(FAQ)
LLMO(大規模言語モデル最適化)の導入や運用に関して、多く寄せられる質問とその回答をまとめました。
施策の検討や見直しの参考にしてください。
Q:LLMO対策の効果が出るまでどのくらいの期間がかかりますか?
対策の内容や対象とするキーワード、業界の競争環境によって異なりますが、早ければ施策開始後1か月程度でAIによる参照・引用の効果が現れることもあります。
弊社(アクシアカンパニー)の実績では、3〜4か月程度でAI引用率が80%を超えるケースもあります。
即効性を求める施策ではなく、Web上に強固な参照網を構築し、中長期的に引用・推奨を安定定着させていくアプローチが基本となります。
Q:自社に都合の悪いAIの回答を法的に削除することはできますか?
AIが出力した生成結果そのものを法的に「削除」することは極めて困難です。
AIの生成結果は問いかけごとに動的に作られるため、特定の回答テキストだけを消去する法的手続きは確立されていません。
ただし、AIが参照する掲示板の書き込みや口コミによって権利が侵害されている場合は、情報流通プラットフォーム対処法(旧プロバイダ責任制限法)等に基づき、削除の申出や発信者情報開示請求を検討できます。
また、こうした法的手続きには、IT・ネットに精通した弁護士への相談や依頼が不可欠となります。
現実的な解決策となるのは、公式サイトや外部メディアを通じて正確な一次情報をWeb上に発信し、AIが参照するデータを最新の正しい事実で上書きすることです。
Q:ChatGPTだけでなくGeminiやPerplexityも同時に対策できますか?
同時に複数のAIエンジンを横断した対策が可能です。
各AIで検索アルゴリズムやデータの重み付けに多少の差異はあるものの、主要なAIの多くはWeb検索と連携したRAG(検索拡張生成)の仕組みを備えており、Web上の情報をもとに回答を生成するという根本的なメカニズムは共通しているためです。
まとめ:AIが「企業の説明役」になる時代、情報の最適化が信用の分かれ道
AI検索の普及により、ユーザーが自社サイトを訪れる前にAIの画面上で意思決定が完結する時代になりました。
しかし、Web上に残る古いデータや断片的な口コミが参照され、ネガティブな回答が提示されることで、知らないうちに顧客や求職者を失うリスクが高まっています。
従来のSEOだけでは、AIが自社をどう説明するかまでをコントロールできません。
企業の信用を守り、正当な参照・引用を獲得するためには、AIのアルゴリズムに最適化したLLMO対策が重要です。
まずは自社がAIにどう評価されているかを把握し、AIに選ばれるために自社コンテンツを最適化しましょう。
【AI検索の風評対策・ブランドLLMO対策のご相談】はアクシアカンパニーへ!
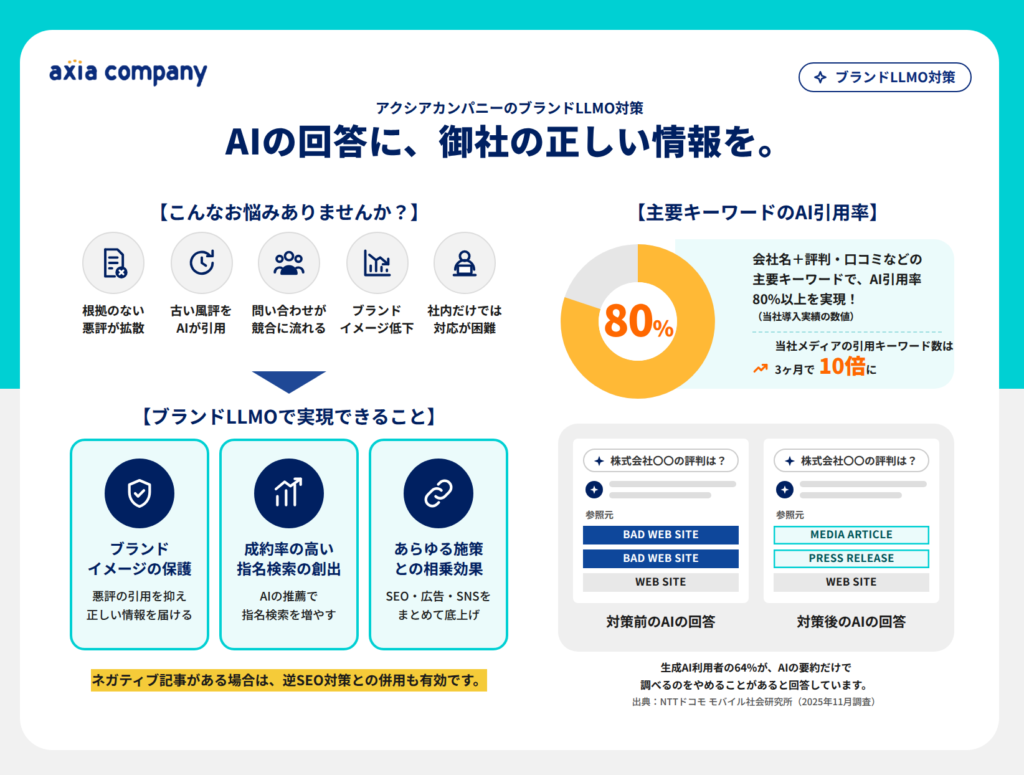
ご安心ください。
私たちアクシアカンパニーは、逆SEO対策1,200件以上の実績と、AIに引用される記事づくりのノウハウを持つプロです。AIが参照する情報源を整え、御社の正しい情報がAIの回答に届くよう、全力でサポートを実施します!
さらに一括払いのお客様には、記事公開から6か月以内に主要キーワードでAIへの表示が確認できなければ、料金を全額返金する保証もご用意しています。
また、アクシアカンパニーではChatGPTやGeminiなどで御社名を調べたときの現在の回答をもとに、無料で見積り作成を行っています。下記のフォームから、いつでも私たちへご相談ください。
今すぐWEBで無料相談